Wer eine Website im Browser öffnet, sieht zunächst nur das Ergebnis: HTML, Bilder, Formulare oder eine komplette Webanwendung. Hinter einer modernen Website können jedoch zahlreiche unterschiedliche Komponenten arbeiten.
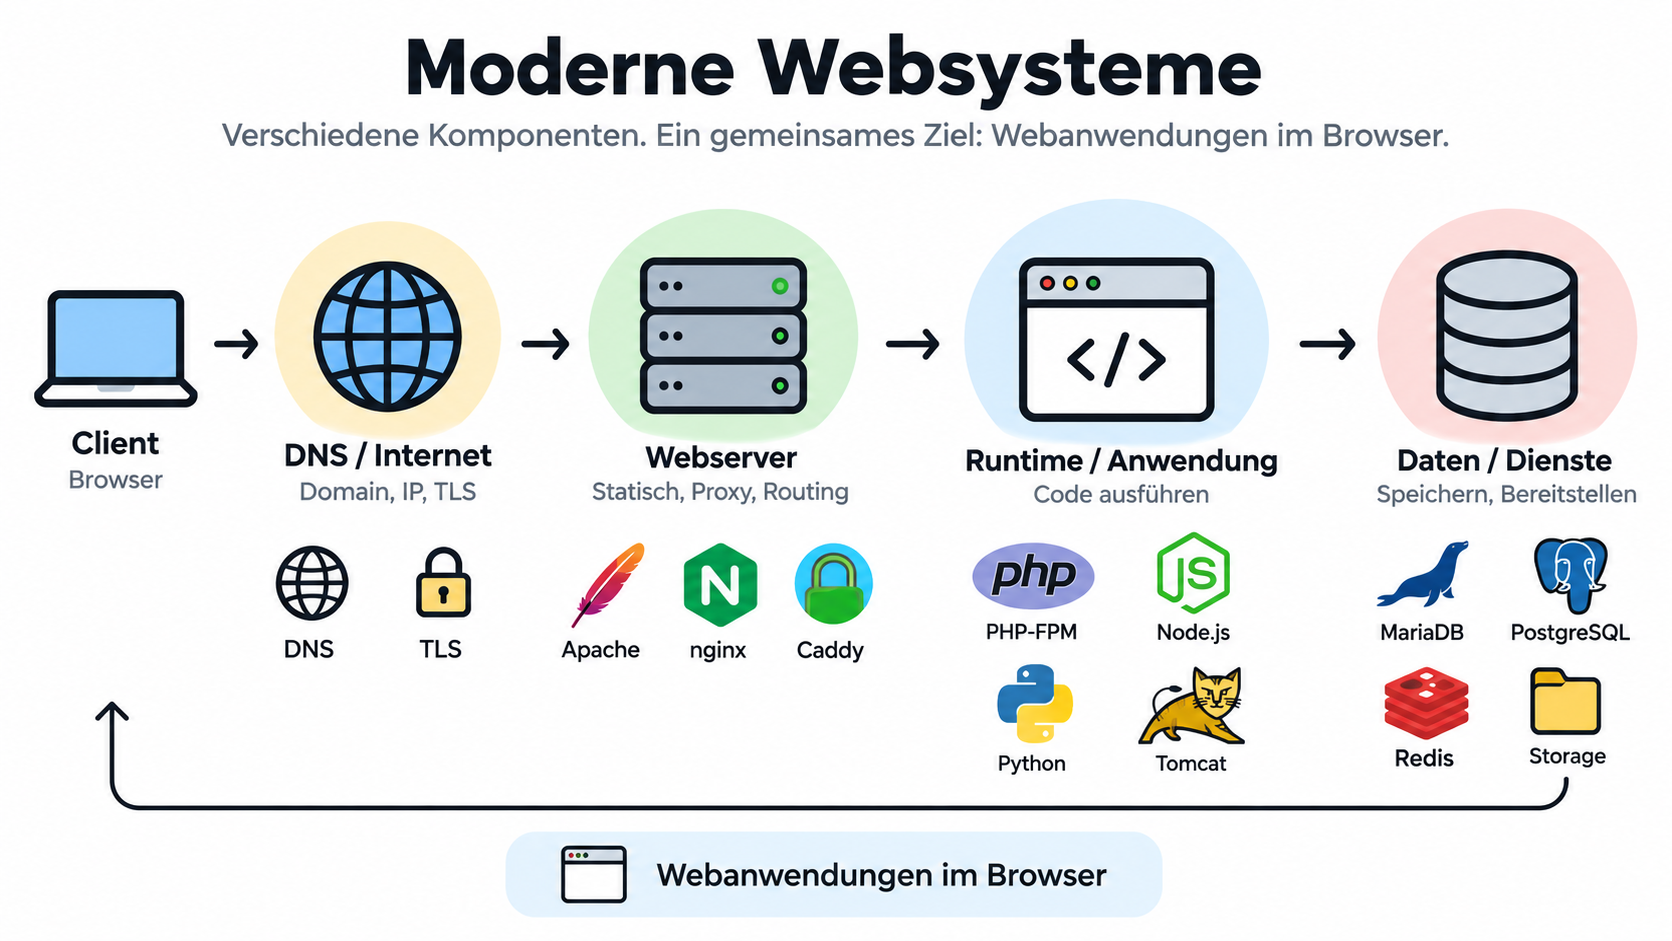
Apache, nginx, PHP, Node.js, Django, Tomcat, PostgreSQL oder Redis übernehmen dabei ganz unterschiedliche Aufgaben. Um moderne Webarchitekturen verstehen zu können, lohnt sich deshalb zunächst ein Blick auf die grundlegenden Bausteine eines Websystems.
Was passiert bei einem Webrequest?
Am Anfang steht der Client – meistens ein Webbrowser. Wird beispielsweise eine URL wie
https://shop.example.de/products?id=42
aufgerufen, enthält sie bereits mehrere wichtige Informationen:
https://shop.example.de:443/products?id=42
  │          │          │      │       │
  │          │          │      │       └─ Query
  │          │          │      └───────── Pfad
  │          │          └──────────────── Port
  │          └─────────────────────────── Hostname
  └────────────────────────────────────── Protokoll
Bevor der eigentliche HTTP-Request übertragen werden kann, muss zunächst geklärt werden, unter welcher IP-Adresse der angegebene Host erreichbar ist. Diese Aufgabe übernimmt das Domain Name System (DNS).
Vereinfacht entsteht damit folgende Kette:
Hostname
   │
   ▼
  DNS
   │
   ▼
IP-Adresse
   │
   ▼
 Server
Anschließend baut der Client eine Verbindung zum Server auf und sendet einen HTTP-Request.
Bei HTTPS kommt zusätzlich TLS zum Einsatz. Dadurch wird die Verbindung verschlüsselt und der Server kann sich gegenüber dem Client mit einem Zertifikat authentifizieren.
Der Webserver
Eine der zentralen Komponenten klassischer Websysteme ist der Webserver. Bekannte Vertreter sind:
- Apache HTTP Server
- nginx
- Caddy
Bei einer statischen Website kann der Webserver die angeforderten Dateien direkt ausliefern.
Browser
   │
   ▼
Webserver
   │
   ▼
HTML · CSS · JavaScript · Bilder
Fordert der Browser beispielsweise /logo.png an, kann der Webserver diese URL unmittelbar einer Datei auf dem Server zuordnen.
GET /logo.png
      │
      ▼
Webserver
      │
      ▼
/var/www/site/logo.png
Für eine solche Website wird keine serverseitige Programmiersprache benötigt.
Dynamische Webanwendungen
Bei einer dynamischen Webanwendung existiert die vollständige Antwort dagegen häufig noch nicht als Datei. Sie wird erst während des Requests erzeugt.
Ein typischer Ablauf sieht beispielsweise so aus:
Browser ──► Webserver ──► Anwendung ──► Datenbank
Die Anwendung verarbeitet den Request, greift gegebenenfalls auf Daten zu und erzeugt daraus beispielsweise HTML oder JSON. Die Antwort gelangt anschließend über den Webserver zurück zum Client.
Bekannte Beispiele für dynamische Webanwendungen sind WordPress, TYPO3, Nextcloud und Django-Anwendungen.
Der klassische LAMP-Stack
Eine der bekanntesten Kombinationen für dynamische Websites ist der LAMP-Stack:
Linux
  │
Apache
  │
MySQL / MariaDB
  │
PHP
LAMP steht ursprünglich für Linux, Apache, MySQL und PHP.
Dieses Modell hat insbesondere die Entwicklung klassischer PHP-Anwendungen geprägt. Anwendungen wie WordPress wurden über viele Jahre typischerweise mit Apache, PHP und MySQL beziehungsweise MariaDB betrieben.
Dabei konnte Apache sehr viele Aufgaben gleichzeitig übernehmen: statische Dateien ausliefern, TLS terminieren, PHP ausführen beziehungsweise anbinden, URLs umschreiben und mehrere Websites auf demselben Server bereitstellen.
PHP-FPM trennt Webserver und PHP
Heute wird PHP häufig nicht mehr direkt innerhalb des Webservers ausgeführt. Stattdessen kommt PHP-FPM zum Einsatz.
Browser
   │
   ▼
Apache / nginx
   │
   │ FastCGI
   ▼
PHP-FPM
   │
   ▼
PHP-Anwendung
Der Webserver nimmt weiterhin HTTP-Requests entgegen. Muss PHP-Code ausgeführt werden, übergibt er den Request über FastCGI an PHP-FPM.
Damit sind Webserver und PHP-Laufzeit voneinander getrennt.
Dieses Prinzip ist für moderne Architekturen wichtig: Eine einzelne Software muss nicht mehr sämtliche Aufgaben übernehmen.
Python und Django
Das gleiche Grundprinzip findet man auch in anderen Ökosystemen.
Eine Django-Anwendung könnte beispielsweise folgendermaßen betrieben werden:
Browser
   │
   ▼
nginx / Apache
   │
   ▼
Gunicorn
   │
   ▼
Django
   │
   ▼
PostgreSQL
Django selbst ist dabei kein Webserver, sondern ein Webframework für Python.
Gunicorn stellt die Verbindung zwischen dem HTTP- beziehungsweise Proxy-Layer und der Python-Anwendung her.
Node.js
Bei Node.js sieht die Situation etwas anders aus. Eine Node.js-Anwendung kann selbst einen HTTP-Port öffnen.
Browser
   │
   ▼
nginx / Caddy
   │
   ▼
Node.js :3000
   │
   ▼
Anwendung
Technisch könnte der Browser auch direkt mit Node.js kommunizieren. In produktiven Umgebungen befindet sich jedoch häufig ein Webserver oder Reverse Proxy davor.
Dieser kann beispielsweise TLS, Routing und die Verteilung von Requests übernehmen.
Java und Tomcat
Auch Java-Webanwendungen verwenden häufig eine eigene Laufzeitumgebung beziehungsweise einen Application Server.
Browser
   │
   ▼
nginx / Apache
   │
   ▼
Tomcat
   │
   ▼
Java-Anwendung
Ein Beispiel hierfür ist XWiki, das typischerweise in einer Java-Servlet-Umgebung wie Tomcat betrieben wird.
Damit wird deutlich: Nicht jede Webanwendung folgt dem klassischen LAMP-Modell.
Unterschiedliche Anwendungen – unterschiedliche Stacks
Je nach Anwendung kann der technische Stack erheblich variieren.
| Anwendung | Runtime | typische Bereitstellung |
|---|---|---|
| WordPress | PHP | Apache oder nginx + PHP |
| Django | Python | Gunicorn + Reverse Proxy |
| Node.js-Anwendung | JavaScript | Node.js + Reverse Proxy |
| XWiki | Java | Tomcat + Reverse Proxy |
| statische Website | keine | Apache, nginx oder Caddy |
Es gibt daher nicht den einen Webstack.
Entscheidend ist vielmehr, welche Komponenten eine Anwendung benötigt und wie diese miteinander verbunden werden.
Was ist ein Framework?
Zusätzlich muss zwischen Programmiersprache, Laufzeit und Framework unterschieden werden.
Ein Framework stellt Strukturen und Bibliotheken für die Entwicklung einer Anwendung bereit.
Programmiersprache
       │
       ▼
    Framework
       │
       ▼
  Webanwendung
Beispiele sind:
| Sprache | Frameworks |
|---|---|
| Python | Django, Flask, FastAPI |
| PHP | Symfony, Laravel |
| JavaScript | Express, NestJS, Next.js |
Ein Framework ersetzt also nicht automatisch den Webserver oder die Laufzeitumgebung.
Reverse Proxies
Mit zunehmender Trennung der Komponenten gewinnt der Reverse Proxy an Bedeutung.
Angenommen, auf einem Server laufen mehrere Anwendungen:
                    ┌────► Node.js :3000
                    │
Internet ─► nginx ──┼────► Django  :8000
                    │
                    └────► Tomcat  :8080
Von außen müssen die internen Ports nicht bekannt sein.
Der Reverse Proxy nimmt die Requests entgegen und entscheidet anhand von Hostnamen oder Pfaden, an welches Backend sie weitergeleitet werden.
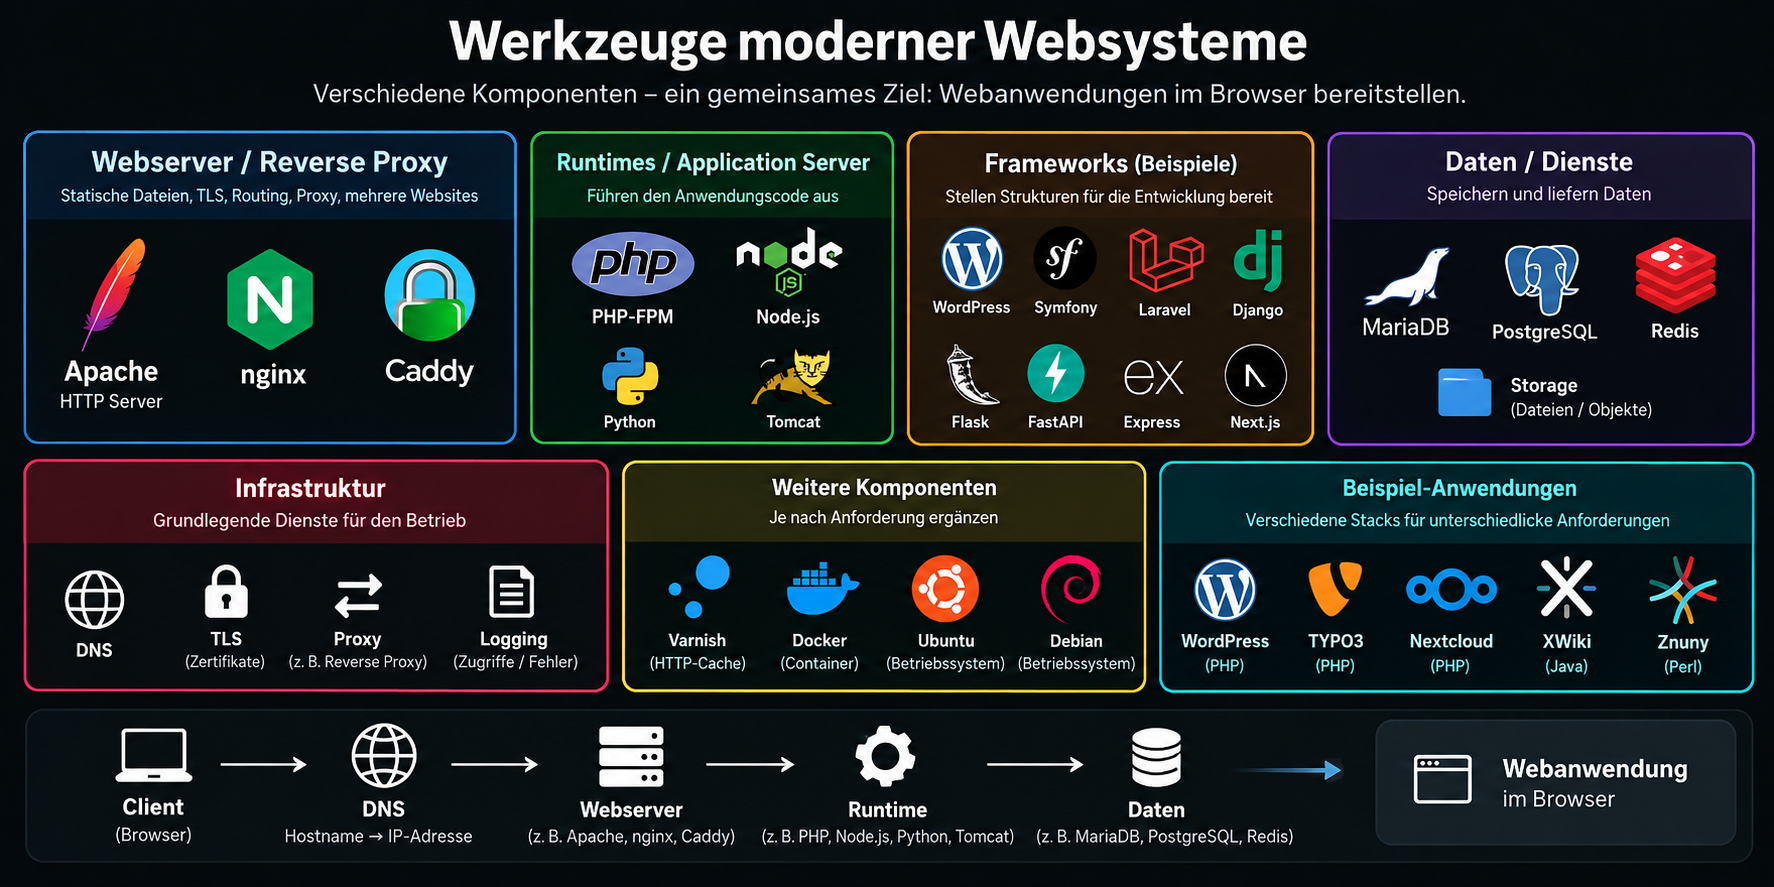
Dadurch entsteht eine zentrale Eingangsschicht für mehrere unterschiedliche Anwendungen.
Welche Informationen benötigt ein Webserver?
Unabhängig vom eingesetzten Produkt müssen bei der Konfiguration immer wieder ähnliche Fragen beantwortet werden:
- Auf welcher IP-Adresse und welchem Port soll ein Dienst lauschen?
- Für welchen Hostnamen ist er zuständig?
- Sollen Dateien ausgeliefert oder Requests an ein Backend weitergeleitet werden?
- Soll HTTP oder HTTPS verwendet werden?
- Welche Header oder Routing-Regeln gelten?
- Wo werden Zugriffe und Fehler protokolliert?
Die konkrete Syntax unterscheidet sich zwischen Apache, nginx oder Caddy. Die zugrunde liegenden Fragen bleiben jedoch ähnlich.
Beispiel: Apache VirtualHost unter Debian
Unter Debian wird die Apache-Konfiguration typischerweise unter /etc/apache2/ verwaltet.
Wichtige Verzeichnisse sind unter anderem:
/etc/apache2/
   ├── apache2.conf
   ├── ports.conf
   ├── sites-available/
   ├── sites-enabled/
   ├── mods-available/
   ├── mods-enabled/
   ├── conf-available/
   └── conf-enabled/
Eine einfache Website könnte beispielsweise unter
/var/www/example
liegen.
Dazu wird ein VirtualHost definiert:
<VirtualHost *:80>
    ServerName www.example.de
    ServerAlias example.de

    DocumentRoot /var/www/example

    ErrorLog ${APACHE_LOG_DIR}/example-error.log
    CustomLog ${APACHE_LOG_DIR}/example-access.log combined
</VirtualHost>
Die wesentlichen Direktiven lassen sich direkt den grundlegenden Konfigurationsfragen zuordnen:
| Apache-Direktive | Bedeutung |
|---|---|
<VirtualHost *:80> | auf welchem Port Apache lauscht |
ServerName | primärer Hostname |
ServerAlias | zusätzliche Hostnamen |
DocumentRoot | Verzeichnis der auszuliefernden Dateien |
Unter Debian kann die Konfiguration anschließend beispielsweise mit a2ensite aktiviert werden.
sudo a2ensite example.conf
Vor dem Neuladen sollte die Konfiguration geprüft werden:
sudo apache2ctl configtest
Erst wenn die Prüfung erfolgreich ist, wird Apache neu geladen:
sudo systemctl reload apache2
Vom DocumentRoot zum Backend
Nicht jede Anwendung besitzt jedoch einen klassischen DocumentRoot.
Eine Node.js-Anwendung könnte beispielsweise auf Port 3000 laufen. Apache kann Requests an diesen Dienst weiterleiten:
www.example.de ──► Apache ──► Node.js :3000
                      Proxy
Der Webserver liefert die Anwendung in diesem Fall nicht selbst aus. Er fungiert als Reverse Proxy.
Genau an dieser Stelle beginnt der Übergang von der klassischen Webserver-Konfiguration zur Webarchitektur.
Von Komponenten zur Architektur
Die grundlegenden Bausteine lassen sich vereinfacht zusammenfassen:
DNS / TLS
    │
    ▼
Webserver ──► Runtime ──► Daten
Dabei können unterschiedliche Technologien eingesetzt werden:
Webserver: Apache, nginx, Caddy
Runtimes: PHP-FPM, Node.js, Python, Tomcat
Daten und Dienste: MariaDB, PostgreSQL, Redis, Storage
Ein Websystem entsteht jedoch nicht allein dadurch, dass diese Komponenten vorhanden sind.
Entscheidend ist ihr Zusammenspiel.
Damit stellt sich die nächste Frage:
Wie werden diese Komponenten zu einer wartbaren, sicheren und flexibel betreibbaren Webarchitektur zusammengesetzt?