Reverse Proxy, Caching, Container und Legacy-Anwendungen
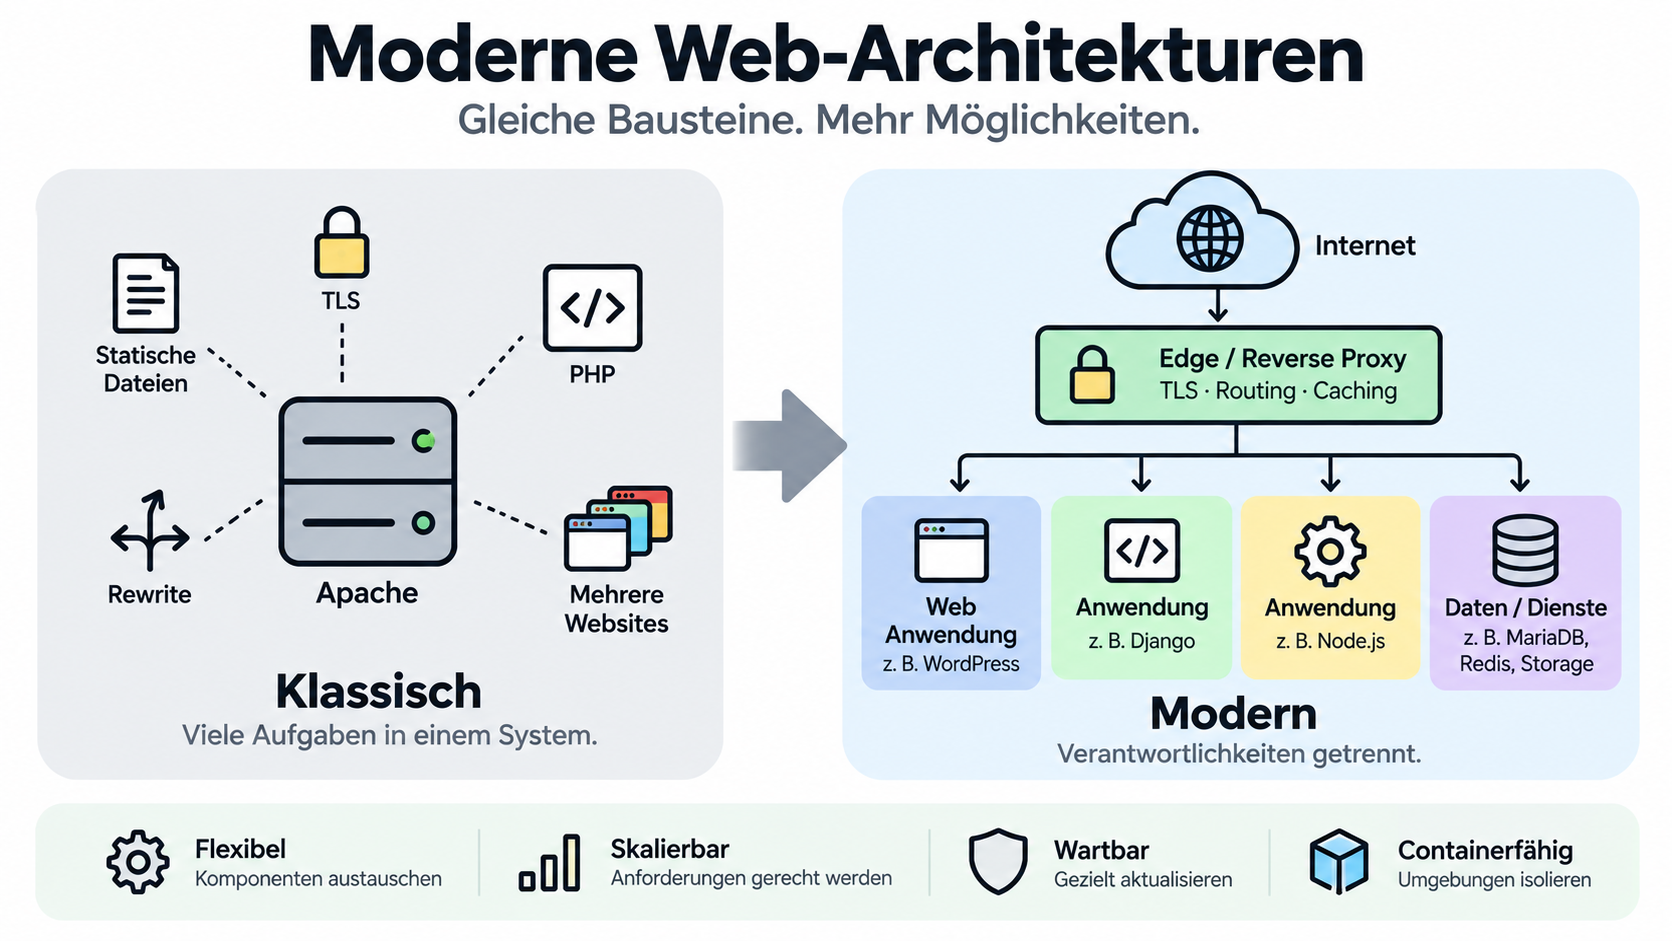
Ein Webserver, eine Laufzeitumgebung und eine Datenbank reichen grundsätzlich aus, um viele Webanwendungen zu betreiben. In produktiven Umgebungen geht es jedoch um mehr als die Frage, ob eine Anwendung grundsätzlich funktioniert.
Updates sollen möglichst ohne lange Ausfallzeiten möglich sein. Unterschiedliche Anwendungen sollen auf demselben System betrieben werden können. Caching soll Last reduzieren. TLS und Routing sollen zentral verwaltet werden. Gleichzeitig existieren Anwendungen, die sehr unterschiedliche Anforderungen an ihre Laufzeitumgebung stellen.
Damit wird aus einzelnen Komponenten eine Webarchitektur.
Vom integrierten Server zur Trennung von Verantwortlichkeiten
Klassische Websysteme wurden häufig stark um einen einzelnen Webserver herum aufgebaut.
Apache konnte beispielsweise gleichzeitig:
Apache
 ├── statische Dateien
 ├── TLS
 ├── PHP
 ├── Rewrite-Regeln
 └── mehrere Websites
Dieses Modell funktioniert bis heute.
Moderne Architekturen trennen Verantwortlichkeiten jedoch häufig stärker:
Edge ──► Cache ──► Application ──► Data
Dabei handelt es sich nicht darum, dass das klassische Modell grundsätzlich falsch wäre. Die Trennung ermöglicht jedoch, einzelne Komponenten unabhängig voneinander auszutauschen, zu skalieren oder zu aktualisieren.
Der Edge als zentrale Eingangsschicht
Als Edge kann die zentrale Eingangsschicht einer Plattform bezeichnet werden.
Internet
   │
   ▼
┌──────────────┐
│     Edge     │
└──────┬───────┘
       ▼
  Anwendungen
Typische Aufgaben dieser Schicht sind:
- TLS-Terminierung
- Routing
- Reverse Proxy
- Weiterleitung anhand von Hostnamen
- teilweise Load Balancing
- zentrale HTTP-Header und Sicherheitsregeln
Als Software können beispielsweise nginx oder Caddy eingesetzt werden.
Wichtig ist dabei die begriffliche Trennung: Ein Reverse Proxy ist eine Funktion, die ein System am Edge übernehmen kann. Edge und Reverse Proxy sind daher nicht vollständig synonym.
Eine stabile Eingangsschicht
Ein großer Vorteil dieser Trennung besteht darin, dass der öffentlich erreichbare Teil der Infrastruktur stabil bleiben kann, während sich die Anwendungen dahinter verändern.
Beispielsweise:
                    ┌─► WordPress
                    │
Internet ─► nginx ──┼─► TYPO3
                    │
                    ├─► XWiki
                    │
                    └─► Znuny
DNS, öffentliche IP-Adressen und TLS-Konfigurationen müssen dadurch nicht bei jedem Austausch eines Backends verändert werden.
Eine Anwendung kann intern auf einen anderen Port, einen anderen Container oder sogar einen anderen Server verschoben werden. Solange der Edge anschließend auf das neue Backend verweist, bleibt die öffentliche Adresse gleich.
Apache, nginx und Caddy
Die drei Webserver verfolgen teilweise unterschiedliche Ansätze.
Apache ist besonders interessant, wenn Anwendungen eng mit Apache-Funktionen verbunden sind. Dazu gehört insbesondere die Unterstützung von .htaccess.
nginx ist als Webserver und Reverse Proxy weit verbreitet und verfügt über ein großes Ökosystem. Zusätzlich besitzt nginx leistungsfähige integrierte Caching-Möglichkeiten.
Caddy legt großen Wert auf eine einfache Konfiguration und automatisiertes TLS.
Vereinfacht lassen sich einige Schwerpunkte gegenüberstellen:
| nginx | Caddy | Varnish |
|---|---|---|
| großes Ökosystem | einfache Konfiguration | spezialisiertes Caching |
| flexible Proxy-Regeln | automatisches TLS | Cache-Steuerung |
| HTTP-Caching | Cache über Erweiterungen | PURGE, BAN und Grace |
Varnish nimmt dabei eine Sonderrolle ein: Es ist primär ein spezialisierter HTTP-Cache und kein allgemeiner Ersatz für einen Webserver.
Das Problem mit .htaccess
.htaccess ist eine Apache-Funktion.
Apache kann solche Dateien in einzelnen Verzeichnissen einlesen und damit Teile seiner Konfiguration dezentral verändern.
Eine Anwendung oder ein Plugin kann dadurch beispielsweise Regeln für
- URL-Rewriting,
- Zugriffsschutz,
- Redirects,
- HTTP-Header oder
- Caching
bereitstellen.
Bei nginx und Caddy existiert dieses Konzept nicht.
Eine vorhandene .htaccess-Datei wird dort nicht automatisch interpretiert.
PHP-FPM ändert daran nichts
Die Verwendung von PHP-FPM beseitigt .htaccess nicht automatisch.
Bei
Apache ──► PHP-FPM
bleibt Apache weiterhin der Webserver. Apache kann deshalb weiterhin .htaccess verarbeiten.
Allerdings gelten PHP-Einstellungen wie php_value oder php_flag nicht mehr in derselben Form wie bei klassischem mod_php.
PHP-Konfiguration gehört bei PHP-FPM typischerweise in die PHP- beziehungsweise FPM-Konfiguration.
Damit werden zwei Konfigurationsebenen getrennt:
Webserver-Konfiguration ──► Apache
PHP-Konfiguration       ──► PHP-FPM
WordPress und .htaccess
WordPress ist ein gutes Beispiel für die Auswirkungen einer engen Bindung an Apache.
Die Kernanwendung kann problemlos hinter nginx oder Caddy betrieben werden. Standardmäßige Permalink-Strukturen lassen sich mit den Routing-Funktionen dieser Webserver abbilden.
Problematischer können jedoch Plugins werden.
Ein Plugin kann davon ausgehen, dass es eine .htaccess-Datei verändert und damit unmittelbar das Verhalten des Webservers beeinflusst.
Unter Apache funktioniert dieses Modell.
Unter nginx oder Caddy kann das Plugin die Datei zwar möglicherweise weiterhin schreiben – der Webserver ignoriert sie jedoch.
Besonders relevant wird dies bei Plugins, die .htaccess für Sicherheitsregeln, Redirects oder Full-Page-Caching verwenden.
.htaccess-Änderungen überwachen
Bei einer Migration von Apache zu einem anderen Webserver kann es deshalb sinnvoll sein, zunächst zu beobachten, welche Komponenten überhaupt .htaccess verändern.
Unter Linux kann beispielsweise inotifywait verwendet werden:
inotifywait -m -r \
  -e create,modify,move,delete \
  --include '(^|/)\.htaccess$' \
  /var/www/wordpress
Zusätzlich kann der Quellcode installierter Plugins nach typischen WordPress-Funktionen durchsucht werden:
grep -RniE \
  'htaccess|insert_with_markers|save_mod_rewrite_rules|flush_rewrite_rules' \
  wp-content/plugins/
Das ersetzt keine vollständige Analyse, gibt aber Hinweise darauf, welche Plugins möglicherweise Apache-spezifische Konfiguration erzeugen.
Apache innerhalb eines Containers
Container bieten eine interessante Möglichkeit, solche Abhängigkeiten zu kapseln.
Statt Apache vollständig aus der Architektur zu entfernen, kann er Bestandteil des WordPress-Containers werden:
Internet
   │
   ▼
nginx / Caddy
   │
   ▼
WordPress-Container
   │
   ├── Apache
   ├── .htaccess
   └── PHP
Damit übernimmt der äußere Webserver beispielsweise TLS und Routing.
Apache bleibt dagegen dort erhalten, wo die Anwendung seine Funktionen erwartet.
Die Apache-Abhängigkeit wird dadurch zu einem Implementierungsdetail der Anwendung und muss nicht mehr die Architektur des gesamten Servers bestimmen.
Nicht jede Anwendung braucht Apache
Andere Anwendungen besitzen völlig andere Anforderungen.
XWiki ist beispielsweise eine Java-Anwendung und wird typischerweise in einer Servlet-Umgebung wie Tomcat betrieben:
Internet
   │
   ▼
nginx / Caddy
   │
   ▼
Tomcat
   │
   ▼
XWiki
Hier spielt .htaccess keine Rolle.
Bei Znuny sieht die Situation wiederum anders aus. Die Perl-Anwendung ist traditionell stark mit Apache und mod_perl verbunden.
Eine mögliche Architektur besteht deshalb darin, Apache nur für diese Anwendung beizubehalten:
Internet
   │
   ▼
nginx / Caddy
   │
   ▼
Apache
   │
   ▼
mod_perl
   │
   ▼
Znuny
mod_perl ist ein Apache-Modul. nginx kann es nicht einfach ersetzen.
Das zeigt einen wichtigen Architekturgrundsatz:
Die Infrastruktur sollte sich an den Anforderungen der Anwendung orientieren – nicht umgekehrt.
Caching als eigene Schicht
Eine weitere mögliche Komponente moderner Webarchitekturen ist ein HTTP-Cache.
Bei WordPress kann ein großer Teil der Requests an anonyme Besucher identische Antworten erzeugen.
Ohne Cache könnte jeder Request die vollständige Verarbeitungskette durchlaufen:
Request
   │
   ▼
PHP
   │
   ▼
WordPress
   │
   ▼
Datenbank
Mit einem Full-Page-Cache kann die Antwort dagegen bereits vorher geliefert werden:
Request
   │
   ▼
Cache
 ├── HIT  ──► Response
 │
 └── MISS ──► Anwendung
Ein Cache-Hit verhindert damit unter Umständen die Ausführung von PHP, WordPress und Datenbankabfragen vollständig.
nginx als Cache
nginx kann selbst HTTP-Antworten beziehungsweise FastCGI-Antworten zwischenspeichern.
Bei WordPress kann daraus beispielsweise folgende Architektur entstehen:
Internet
   │
   ▼
nginx
   │
   ├── Cache HIT ──► Response
   │
   └── Cache MISS
          │
          ▼
       PHP-FPM
          │
          ▼
      WordPress
          │
          ▼
       MariaDB
Für viele Installationen ist das bereits ausreichend.
Wichtig ist jedoch die Definition, welche Requests überhaupt gecacht werden dürfen.
Administrationsbereiche, eingeloggte Benutzer, Warenkörbe, Checkout-Seiten oder andere personalisierte Inhalte müssen typischerweise vom Full-Page-Caching ausgeschlossen werden.
Warum Varnish?
Varnish ist auf HTTP-Caching spezialisiert.
Der wesentliche Vorteil gegenüber einem einfacheren Cache liegt nicht zwangsläufig darin, dass eine einzelne Cache-Antwort grundsätzlich schneller ausgeliefert wird.
Interessanter sind die Möglichkeiten zur Verwaltung des Cache-Lebenszyklus.
Dazu gehören beispielsweise:
PURGE entfernt gezielt Cache-Inhalte.
BAN kann Gruppen von Objekten anhand definierter Kriterien ungültig machen.
Grace ermöglicht es, ältere Cache-Inhalte vorübergehend weiter auszuliefern.
Request Coalescing kann verhindern, dass bei einem Cache-Miss sehr viele identische Requests gleichzeitig das Backend belasten.
Damit eignet sich Varnish besonders für Umgebungen, in denen Cache-Steuerung und Invalidierung komplexer werden.
Cache-Invalidierung ist entscheidend
Caching ist nur dann sinnvoll, wenn Änderungen zuverlässig sichtbar werden.
Wird beispielsweise ein WordPress-Beitrag geändert, können verschiedene Seiten davon betroffen sein:
- der Beitrag selbst,
- die Startseite,
- Kategoriearchive,
- Tag-Seiten,
- Autorenarchive.
Ein leistungsfähiges Cache-Konzept muss deshalb nicht nur Antworten speichern, sondern auch festlegen, wann diese wieder ungültig werden.
Gerade hier kann ein spezialisiertes System wie Varnish Vorteile bieten.
Mehrere Cache-Schichten
Nicht jeder Cache erfüllt dieselbe Aufgabe.
Eine mögliche WordPress-Architektur könnte beispielsweise so aussehen:
Browser Cache
     │
     ▼
Varnish
Full-Page-Cache
     │
     ▼
Webserver
     │
     ▼
PHP-FPM + OPcache
     │
     ▼
WordPress
     │
     ▼
Redis Object Cache
     │
     ▼
MariaDB
Diese Caches arbeiten auf unterschiedlichen Ebenen.
Der Browser-Cache reduziert Netzwerkrequests.
Varnish speichert vollständige HTTP-Antworten.
OPcache hält kompilierten PHP-Bytecode im Speicher.
Redis kann von WordPress als Object Cache genutzt werden und reduziert wiederholte Datenbankarbeit.
Problematisch wird es dagegen, wenn mehrere Systeme gleichzeitig dieselbe Aufgabe übernehmen.
Varnish, nginx FastCGI Cache und ein WordPress-Full-Page-Cache-Plugin parallel zu betreiben, kann die Invalidierung unnötig kompliziert machen.
Ein klar verantwortlicher Full-Page-Cache ist meistens leichter zu verstehen und zu betreiben.
Container als Architekturbaustein
Container verändern nicht die grundlegenden Anforderungen einer Anwendung.
Sie ermöglichen aber, Laufzeitumgebungen voneinander zu isolieren.
Auf einem Host könnten beispielsweise unterschiedliche Anwendungen mit völlig unterschiedlichen Anforderungen betrieben werden:
HOST
 │
 ├── Edge
 │
 ├── WordPress
 │     └── Apache + PHP
 │
 ├── TYPO3
 │     └── PHP
 │
 ├── XWiki
 │     └── Java + Tomcat
 │
 └── Znuny
       └── Apache + mod_perl
Jede Anwendung kann dadurch ihre eigene passende Laufzeitumgebung mitbringen.
Ein Apache-Upgrade für eine Anwendung muss dann nicht zwangsläufig Auswirkungen auf alle anderen Anwendungen haben.
Persistente Daten gehören nicht einfach in den Container
Container sollten austauschbar sein.
Daten, die einen Austausch überleben müssen, benötigen deshalb eine persistente Ablage.
Dazu gehören beispielsweise:
- Datenbanken,
- hochgeladene Dateien,
- Dokumente,
- bestimmte Anwendungskonfigurationen,
- gegebenenfalls dynamisch installierte Plugins oder Erweiterungen.
Das führt zu einer wichtigen Trennung:
Container
   │
   │ austauschbar
   ▼
Application

Persistent
   │
   ▼
DB · Redis · Storage
Je konsequenter diese Trennung umgesetzt wird, desto einfacher können Anwendungsinstanzen ersetzt werden.
Blue/Green Deployments
Diese Austauschbarkeit kann für Blue/Green Deployments genutzt werden.
Dabei existieren zwei Versionen einer Anwendung:
             ┌──► Application Blue
Edge / Cache ┤
             └──► Application Green
Blue könnte die aktuell produktive Version sein.
Green wird parallel mit der neuen Version aufgebaut und getestet.
Anschließend wird der Traffic auf Green umgeschaltet.
Der öffentliche Edge, die Domains und die TLS-Konfiguration müssen dafür nicht verändert werden.
Ein Rollback kann prinzipiell durch Zurückschalten auf Blue erfolgen.
Die Datenbank ist die schwierige Seite von Blue/Green
Bei zustandslosen Anwendungskomponenten funktioniert dieses Verfahren vergleichsweise einfach.
Schwieriger wird es bei Datenbanken.
Führt eine neue Anwendungsversion eine nicht rückwärtskompatible Schemaänderung durch, kann die alte Version möglicherweise nicht mehr mit der Datenbank arbeiten.
Blue ──┐
       ├──► gemeinsame Datenbank
Green ─┘
Blue/Green für den Anwendungscode bedeutet deshalb nicht automatisch Blue/Green für das gesamte System.
Datenbankmigrationen müssen gesondert geplant werden.
TYPO3 und mehrere Domains
TYPO3 eignet sich gut, um einen weiteren Architekturpunkt zu verdeutlichen: Eine Anwendungsinstanz muss nicht zwangsläufig genau einer Domain entsprechen.
Eine TYPO3-Installation kann mehrere Sites und Domains bedienen.
firma.de ──────┐
firma.at ──────┼──► TYPO3
example.com ───┘
Der Edge leitet die Requests an TYPO3 weiter. Der ursprüngliche Hostname bleibt erhalten, sodass TYPO3 entscheiden kann, welche Site ausgeliefert werden soll.
Bei vielen Subdomains können zusätzlich Wildcard-DNS und Wildcard-Zertifikate sinnvoll sein.
Nextcloud als Plattform
Nextcloud zeigt wiederum, dass nicht jede Webanwendung wie eine klassische Website behandelt werden sollte.
Neben der eigentlichen Nextcloud-Anwendung können weitere Dienste beteiligt sein:
Internet
   │
   ▼
Edge
   │
   ├──► Nextcloud
   ├──► Collabora
   └──► externe Apps
Dazu kommen typischerweise:
Nextcloud
   ├── Datenbank
   ├── Redis
   └── Storage
Gerade Storage ist hier ein eigenständiger Infrastrukturbaustein.
Nextcloud kann lokalen Primärspeicher, Objektspeicher oder verschiedene externe Speicherquellen einbinden.
Collabora wiederum kann als separater Dienst betrieben und unabhängig von Nextcloud aktualisiert werden.
Container eignen sich deshalb besonders gut, um diese Dienste voneinander zu trennen.
Nicht jede Anwendung sollte gecacht werden
Eine wichtige Konsequenz aus solchen Beispielen lautet: Architekturbausteine dürfen nicht schematisch vor jede Anwendung gesetzt werden.
Ein öffentlicher WordPress-Blog kann stark von Full-Page-Caching profitieren.
Eine Nextcloud-Instanz verarbeitet dagegen überwiegend authentifizierte und benutzerspezifische Requests, WebDAV-Zugriffe sowie Dateiübertragungen. Ein allgemeiner Full-Page-Cache wäre dort meist nicht sinnvoll.
Ähnliches gilt für ein Ticketsystem wie Znuny.
Caching muss deshalb immer anhand der Eigenschaften der Anwendung bewertet werden.
Eine mögliche Gesamtarchitektur
Aus den einzelnen Überlegungen kann beispielsweise folgende Plattform entstehen:
                         Internet
                            │
                            ▼
                       nginx / Caddy
                           Edge
                            │
       ┌─────────┬──────────┼─────────┬──────────┐
       ▼         ▼          ▼         ▼          ▼
   WordPress   TYPO3      XWiki     Znuny    Nextcloud
       │         │          │         │          │
    Apache      PHP       Tomcat    Apache    PHP / Apps
Caching kann gezielt dort ergänzt werden, wo es einen Vorteil bietet.
Die Anwendungen verwenden jeweils die Laufzeitumgebung, die zu ihren Anforderungen passt.
Datenbanken, Redis und Storage bilden davon getrennte persistente Dienste.
Architektur bedeutet nicht möglichst viele Komponenten
Eine moderne Architektur ist nicht automatisch besser, nur weil sie aus Reverse Proxy, Varnish, Redis, mehreren Containern und zahlreichen weiteren Diensten besteht.
Jede zusätzliche Komponente erhöht auch den Betriebsaufwand.
Die entscheidenden Fragen sind daher:
- Welche Verantwortung soll eine Komponente übernehmen?
- Welche Anwendung benötigt diese Funktion?
- Welche Abhängigkeiten bestehen?
- Welche Daten müssen persistent sein?
- Welche Komponenten sollen unabhängig aktualisiert werden können?
- Wo ist Caching sinnvoll?
- Wie funktioniert Cache-Invalidierung?
- Welche Teile müssen bei einem Fehler weiter funktionieren?
- Wie kann eine Änderung zurückgerollt werden?
Erst aus diesen Anforderungen ergibt sich eine sinnvolle Architektur.
Fazit
Klassische Webserver-Architekturen und moderne, stärker getrennte Architekturen sind keine Gegensätze, bei denen eine Seite grundsätzlich richtig und die andere falsch ist.
Apache kann beispielsweise weiterhin die beste Laufzeitumgebung für eine Anwendung sein, die .htaccess oder mod_perl benötigt. Gleichzeitig kann nginx oder Caddy davor als stabiler Edge dienen.
Varnish kann bei stark gecachten öffentlichen Websites sinnvoll sein, während andere Anwendungen überhaupt keinen Full-Page-Cache benötigen.
Container können unterschiedliche Laufzeitumgebungen voneinander isolieren, lösen aber weder Persistenz noch Datenbankmigrationen automatisch.
Der zentrale Gedanke ist deshalb die Trennung von Verantwortlichkeiten:
Internet
   │
   ▼
Edge
   │
   ▼
Cache
   │
   ▼
Application
   │
   ▼
Data
Nicht jede Architektur benötigt jede dieser Schichten. Das Modell hilft jedoch dabei, die Aufgaben eines Websystems bewusst zuzuordnen.
Eine gute Webarchitektur entsteht damit nicht durch die Auswahl möglichst moderner Technologien, sondern dadurch, dass jede Komponente eine klar definierte Aufgabe erhält und zu den Anforderungen der jeweiligen Anwendung passt.